Voix en temps réel
Le pipeline WebRTC à faible latence pour les agents vocaux — STT, LLM, TTS en streaming sur un seul chemin.
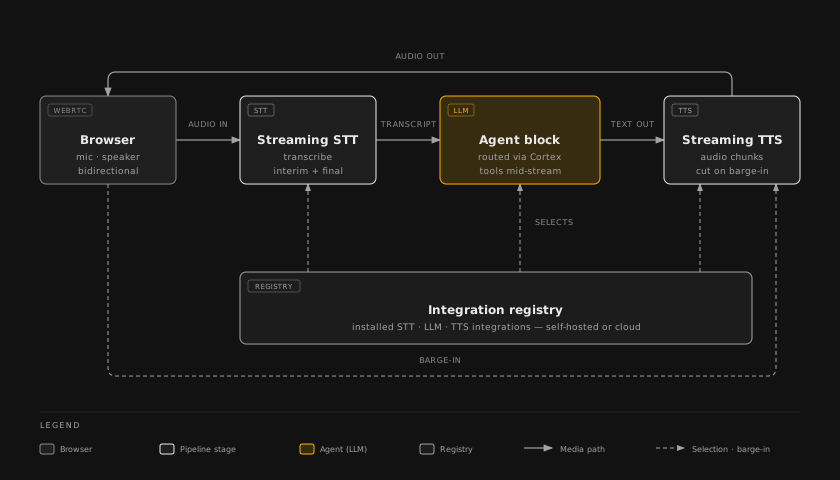
Le sous-système vocal en temps réel exécute les agents vocaux de bout en bout : microphone en entrée, transcription traitée par le LLM, audio en sortie, avec une latence inférieure à la seconde. Il s'exécute dans le même espace de noms que le moteur de workflow et partage la même autorisation, le même audit et le même registre d'intégrations.

Ce qu'il fait
| Capacité | Détail |
|---|---|
| Entrée WebRTC | Audio bidirectionnel à faible latence entre le navigateur et votre cluster. |
| STT en streaming | Reconnaissance vocale via toute intégration STT installée (Azure Speech, Whisper, Voxtral, …). |
| Boucle agent | La transcription alimente l'exécution d'un bloc Agent ; les appels d'outils sont émis en cours de stream. |
| TTS en streaming | Synthèse vocale via toute intégration TTS installée. |
| Interruption | L'utilisateur peut interrompre l'agent en milieu de phrase ; la sortie audio est tronquée proprement. |
Comment les capacités sont routées
Les agents vocaux suivent le même modèle de résolution des capacités que tout le reste. Chaque appel sélectionne un fournisseur via le registre d'intégrations :
- STT — sélectionné parmi les intégrations STT installées. Le modèle par défaut est le modèle STT par défaut de l'organisation.
- LLM — sélectionné parmi les intégrations LLM installées. Routé via Cortex.
- TTS — sélectionné parmi les intégrations TTS installées. La voix par défaut est la voix TTS par défaut de l'organisation.
Chaque élément peut être auto-hébergé ou dans le cloud. Une organisation peut faire tourner une pile vocale entièrement sur cluster (par ex. Whisper + vLLM + un TTS local) ou combiner un STT auto-hébergé avec un LLM cloud et une voix cloud.
Position dans l'architecture
Le service vocal s'exécute dans l'espace de noms scrydon-agentic comme service jumeau du moteur de workflow standard. Il dépend de :
- Platform — pour l'authentification des utilisateurs et la validation de session.
- Cortex — pour chaque appel LLM.
- Registre d'intégrations — pour la sélection des fournisseurs STT et TTS.
- Coturn / Traefik — pour la signalisation WebRTC et TURN si vous avez besoin de traversée NAT.
Considérations clients
- Latence. Un STT + LLM auto-hébergés sur GPU co-localisé offrent la latence de bout en bout la plus faible. Les fournisseurs cloud ajoutent le RTT réseau.
- Trafic sortant. Si votre politique réseau interdit le trafic sortant vers les points de terminaison vocaux / LLM cloud, choisissez des variantes auto-hébergées pour le STT et le TTS.
- Conservation de l'audio. La plateforme ne conserve pas l'audio brut par défaut. Les transcriptions suivent la politique de journal d'audit de votre workflow.
Voir aussi
- Intégrations → Capacités — définitions des capacités STT / TTS.
- Architecture → Cortex — la passerelle LLM derrière la boucle vocale.
- Sécurité → Journalisation d'audit — les sessions vocales émettent les mêmes événements d'audit que les exécutions textuelles.