Agent
Créez des agents IA puissants avec n'importe quel fournisseur LLM
Le bloc Agent sert d'interface entre votre workflow et les grands modèles de langage (LLM). Il exécute des requêtes d'inférence auprès de différents fournisseurs d'IA, traite les entrées en langage naturel selon des instructions définies, et génère des sorties structurées ou non structurées à destination des blocs en aval.
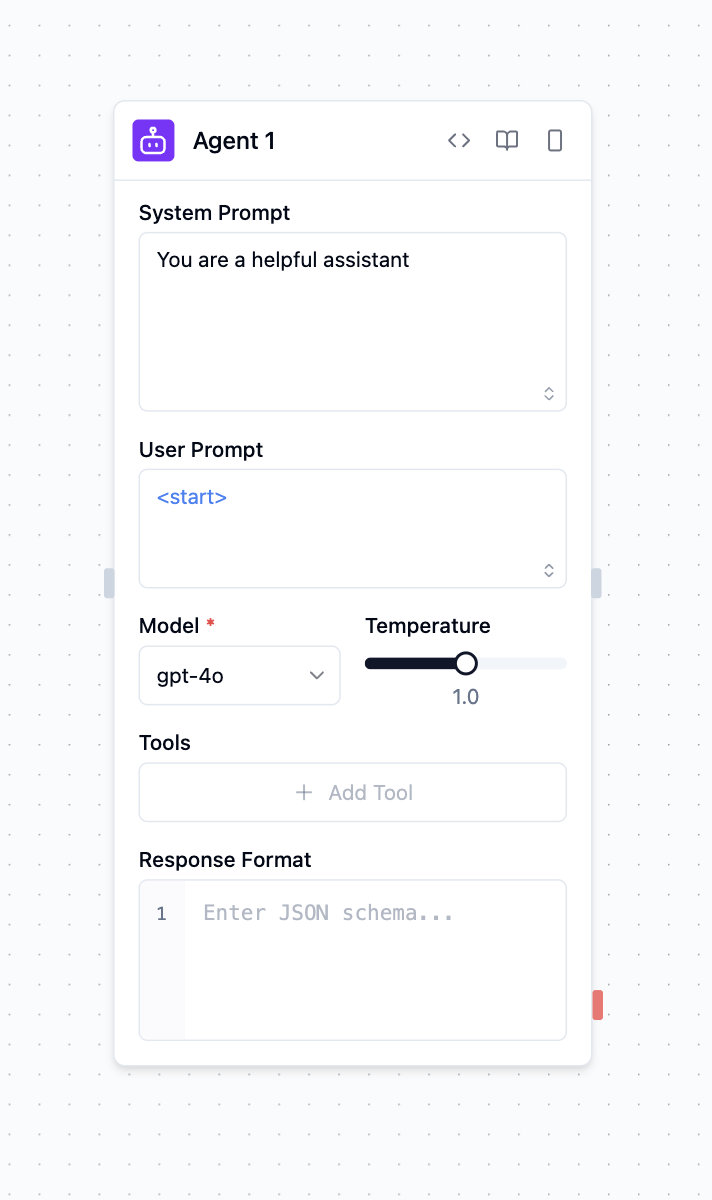
Vue d'ensemble
Le bloc Agent vous permet de :
Traiter le langage naturel : analyser les entrées utilisateur et générer des réponses contextuelles
Exécuter des tâches pilotées par l'IA : effectuer des analyses de contenu, de la génération et de la prise de décision
Appeler des outils externes : accéder à des API, des bases de données et des services durant le traitement
Générer une sortie structurée : renvoyer des données JSON conformes à vos exigences de schéma
Options de configuration
Invite système
L'invite système établit les paramètres opérationnels et les contraintes comportementales de l'agent. Cette configuration définit le rôle de l'agent, sa méthodologie de réponse et ses limites de traitement pour toutes les requêtes entrantes.
You are a helpful assistant that specializes in financial analysis.
Always provide clear explanations and cite sources when possible.
When responding to questions about investments, include risk disclaimers.
Invite utilisateur
L'invite utilisateur représente les données d'entrée principales pour le traitement de l'inférence. Ce paramètre accepte du texte en langage naturel ou des données structurées que l'agent va analyser et auxquelles il va répondre. Les sources d'entrée incluent :
- Configuration statique : texte saisi directement dans la configuration du bloc
- Entrée dynamique : données transmises depuis des blocs en amont via les interfaces de connexion
- Génération à l'exécution : contenu généré par programme lors de l'exécution du workflow
Objectif
Utilisez le champ facultatif Objectif lorsque l'Agent doit atteindre un résultat plutôt que répondre à une seule invite. L'objectif est ajouté à la conversation Agent normale ; le même bloc conserve la sélection du modèle, la mémoire, la sortie structurée et les outils de plateforme. Ses outils shell et fichier intégrés s'exécutent pendant le tour isolé. Un objectif peut donc demander à l'Agent de cloner un dépôt, installer les dépendances, lancer un build et ne rapporter que les résultats réellement observés.
Sélection du modèle
Le bloc Agent ne référence aucun fournisseur par son nom. Il déclare un besoin en capacité LLM et le registre d'intégrations de la plateforme résout la requête auprès des fournisseurs installés — d'abord par surcharge à l'appel, puis par politique organisationnelle, puis par sélection automatique parmi les fournisseurs installés.
Fournisseurs proposant la capacité LLM aujourd'hui :
- Anthropic — famille Claude via l'API Messages
- OpenAI — famille GPT via
openai-chat-v1 - Mistral — modèles Mistral via
openai-chat-v1 - AWS Bedrock — modèles fondamentaux via
bedrock-converse-v1 - Azure AI Foundry — modèles déployés par organisation
- Google Cloud (Vertex AI) — Gemini via
openai-chat-v1 - Ollama — LLM locaux via endpoint compatible OpenAI
- vLLM — inférence haute performance auto-hébergée
Température
Contrôlez la créativité et l'aléatoire des réponses :
Réponses plus déterministes et ciblées. Idéal pour les tâches factuelles, le support client et les situations où la précision est critique.
La plage de température (0-1 ou 0-2) varie selon le modèle sélectionné.
Modèle
Choisissez Par défaut pour utiliser le modèle configuré dans Paramètres → Plateforme → Valeurs par défaut, ou sélectionnez un modèle pour le remplacer dans ce workflow. L'option Par défaut n'enregistre aucune valeur de modèle. Le bloc Agent ne propose aucun sélecteur de connexion ou de credential : la plateforme résout automatiquement une connexion admissible pour l'environnement actif à chaque tour du modèle.
Les clés API et identifiants de compte OAuth ne figurent jamais dans le bloc Agent ni dans le payload d'exécution. Les frontières de l'API LLM rejettent les champs de credential fournis par l'appelant au lieu de les utiliser pour l'envoi.
Sur chacun des chemins de la fabrique d'exécution, le runner Agent ne reçoit que des autorisations limitées à cette exécution. Le rappel transmet le tour sans identifiant à api-platform ; les identifiants et l'appel du fournisseur restent hors d'Agentic et hors du runner. La trace d'exécution indique si cette invocation a été liée au niveau microvm ou au niveau managed_process, explicitement plus faible.
Messages
Un nouvel Agent commence par un message System qui définit son comportement général, ses règles et son contexte. Le sélecteur de rôle et son texte d'aide permettent de choisir User (la demande ou l'entrée) ou Assistant (une réponse antérieure fournie comme contexte de conversation). Lors de l'ajout d'un message, l'éditeur choisit le premier rôle encore absent — System, puis User, puis Assistant — et revient à User lorsque les trois rôles sont déjà représentés. Le générateur de prompt s'applique au message sélectionné le plus récemment.
Outils
Les outils étendent les capacités de l'agent via l'appel de fonctions. Les outils proviennent de produits de fournisseurs — jamais d'un pool global unifié. Lorsque vous cliquez sur « Ajouter des outils » sur le bloc Agent, vous choisissez dans le catalogue de fournisseurs installés : chaque produit apporte son propre ensemble d'outils (par ex. google:gmail apporte send-mail, list-messages, … ; scrydon:knowledge apporte knowledge-rag-search).
Les blocs exécutables de la catégorie Core du workflow apparaissent aussi automatiquement sous Blocks : A2A, API, Create Process Instance, Function, Knowledge, Memory, Search (recherche web), SFTP, SSH, Storage, Table Write, Translate et Workflow. Create Process Task est temporairement masqué pour les nouvelles créations, tandis que les workflows enregistrés existants restent chargeables. Les blocs récursifs ou spécialisés (Agent, Evaluator, Router et Workflow Input) sont volontairement omis. Les outils MCP restent accessibles via les entrées dédiées à leurs serveurs.
Chaque Agent reçoit aussi automatiquement quatre outils de sandbox : run_shell, read_file, write_file et list_dir. Ils s'exécutent dans le runner Agent lié, partagent un répertoire éphémère /workdir pendant ce tour et renvoient au modèle les sorties réellement observées. L'image contient notamment Git, curl, grep/ripgrep, Python avec pip, jq, les outils d'archive, les outils de compilation natifs (make, gcc/g++) et Bun comme runtime JavaScript/TypeScript compatible Node et gestionnaire de paquets (bun install, bun run, bunx ; node, npm et npx en sont des alias). Les registres de paquets (PyPI, npm) sont joignables par défaut, de sorte qu'un Agent peut installer ce dont une tâche a besoin.
L'accès réseau reste régi par la politique de sortie informatique de votre organisation. Les auteurs de workflows ne peuvent pas élargir cette politique depuis un bloc Agent. La présence d'un client CLI ne lui accorde pas un accès réseau illimité, et l'espace de travail est supprimé après le tour.
Les identifiants des fournisseurs et des outils standard restent côté serveur. Les outils sans identifiant peuvent utiliser un exécuteur isolé lorsque leur répartiteur le prend en charge ; les outils fournisseur/personnalisés avec identifiant sont refusés lorsque l'isolation est obligatoire, jusqu'à ce qu'ils disposent d'un contrat d'accès fourni par un courtier et limité à l'exécution. Les outils MCP configurés sur un Agent refusent eux aussi avant la découverte ou tout accès réseau lorsque l'isolation est obligatoire. Seule l'activité de workflow autonome visant un serveur MCP HTTPS sans identifiant, explicitement autorisé par un administrateur, dispose aujourd'hui d'une route vers le plan d'exécution. Le niveau d'isolation sélectionné dans la trace constitue la preuve pour une exécution donnée.
Processus d'intégration des outils :
- Ouvrez la section Outils sur le bloc Agent
- Sélectionnez un produit fournisseur dans le catalogue installé
- Ajoutez un ou plusieurs outils du produit et (si requis) configurez un identifiant
Origine des outils :
- Intégrés : voir
scrydon— Knowledge, Memory, Storage, Tables, Workflow, Web, SMTP, SMS, Guardrails, A2A, SSH - Productivité et stockage : Google, Microsoft, Atlassian, GitHub, Salesforce, …
- Personnalisés : créez les vôtres avec le SDK d'authoring des intégrations et téléversez-les via les Paramètres
Contrôle de l'exécution des outils :
- Auto : le modèle détermine l'invocation des outils selon le contexte et la nécessité
- Requis : l'outil doit être appelé lors de chaque requête d'inférence
- Aucun : la définition de l'outil est disponible mais exclue du contexte du modèle
Format de réponse
Le paramètre Format de réponse impose la génération de sorties structurées via la validation par JSON Schema. Cela garantit des réponses cohérentes et lisibles par les machines, conformes à des structures de données prédéfinies :
{
  "name": "user_analysis",
  "schema": {
    "type": "object",
    "properties": {
      "sentiment": {
        "type": "string",
        "enum": ["positive", "negative", "neutral"]
      },
      "confidence": {
        "type": "number",
        "minimum": 0,
        "maximum": 1
      }
    },
    "required": ["sentiment", "confidence"]
  }
}
Cette configuration contraint la sortie du modèle à respecter le schéma spécifié, empêchant les réponses en texte libre et garantissant la génération de données structurées.
Accéder aux résultats
Après l'exécution d'un agent, vous pouvez accéder à ses sorties :
<agent.content>: le texte de réponse ou les données structurées de l'agent<agent.tokens>: statistiques d'utilisation des tokens (invite, complétion, total)<agent.tool_calls>: détails des outils utilisés par l'agent durant l'exécution<agent.cost>: coût estimé de l'appel API (si disponible)
Fonctionnalités avancées
Intégration de la mémoire
Les agents peuvent maintenir le contexte entre les interactions grâce au système de mémoire :
// In a Function block before the agent
const memory = {
  conversation_history: previousMessages,
  user_preferences: userProfile,
  session_data: currentSession
};
Validation de la sortie structurée
Utilisez JSON Schema pour garantir des réponses cohérentes et lisibles par les machines :
{
  "type": "object",
  "properties": {
    "analysis": {"type": "string"},
    "confidence": {"type": "number", "minimum": 0, "maximum": 1},
    "categories": {"type": "array", "items": {"type": "string"}}
  },
  "required": ["analysis", "confidence"]
}
Gestion des erreurs
Les agents gèrent automatiquement les erreurs courantes :
- Limites de débit API avec recul exponentiel
- Appels d'outils invalides avec logique de réessai
- Échecs réseau avec récupération de connexion
- Erreurs de validation de schéma avec réponses de repli
Récupérer des fichiers
Le bac à sable est supprimé à la fin du tour : un fichier généré par un Agent ne survit donc pas de lui-même. publish_file est le moyen de le transmettre : l'Agent nomme un fichier qu'il a écrit, la plateforme le stocke pour cette exécution, et l'Agent reçoit une URL qu'il peut inclure dans sa réponse. Les fichiers publiés apparaissent aussi dans la sortie files du bloc. Ils sont regroupés dans une section Fichiers de l'entrée de console du bloc, où une image, un extrait audio ou une vidéo se lit sur place, tout autre type étant proposé en téléchargement.
Utilisez-le pour tout contenu généré — un graphique, une image, un extrait audio, un rapport. Demandez-le dans l'invite (« enregistre le graphique et publie-le ») pour en être sûr.
Les fichiers sont stockés pour l'espace de travail et l'exécution qui les ont produits : les personnes qui voient cette exécution peuvent les ouvrir. L'Agent ne détient jamais d'identifiants de stockage — les octets passent par un canal gouverné et la plateforme effectue l'écriture.
La publication dispose de son propre budget, distinct des autres appels de l'Agent, afin qu'un fichier volumineux ne prive pas ses appels de modèle et d'outils. Les fichiers jusqu'à 5 Mo sont publiés en une seule requête. Au-delà, jusqu'à 56 Mo, l'envoi est fractionné ; ce chemin exige un stockage objet cloud, donc un déploiement sur disque local conserve la limite de 5 Mo.
Les fichiers publiés sont générés par un modèle et sont servis en téléchargement plutôt qu'affichés, à l'exception des images, audio et vidéos ordinaires. Un .html ou .svg généré sera téléchargé au lieu de s'ouvrir : c'est délibéré, car afficher du balisage écrit par un modèle lui permettrait d'agir avec votre session.
Un tour d'Agent isolé dispose d'un budget d'exécution fixe dans le bac à sable (10 minutes). Un tour qui ne se termine pas dans ce délai est arrêté par le Runtime Plane, le bloc échoue avec exec timed out after 600s, et l'échec est visible dans le panneau Traces sous la ligne de charge de travail. Il n'est volontairement pas réessayé dans un nouveau bac à sable : le même travail s'exécuterait avec le même budget. Découpez la tâche, ou donnez à l'Agent un objectif plus étroit, plutôt que de compter sur une exécution plus longue.
Un bac à sable ne peut atteindre que les hôtes autorisés par la politique de sortie de l'organisation (les registres de paquets sont autorisés par défaut). Un appel curl ou pip vers un hôte non autorisé échoue immédiatement dans le bac à sable — l'Agent signalera qu'il n'a pas pu accéder à la ressource. Ajoutez l'hôte à la liste d'autorisation de sortie de l'espace de travail, ou transmettez le contenu en entrée, plutôt que de demander à l'Agent de le récupérer.
Entrées et sorties
Invite système : instructions définissant le comportement et le rôle de l'agent
Invite utilisateur : texte d'entrée ou données à traiter
Modèle : sélection du modèle IA (OpenAI, Anthropic, Google, etc.)
Température : contrôle de l'aléatoire des réponses (0-2)
Outils : tableau des outils disponibles pour l'appel de fonctions
Format de réponse : JSON Schema pour la sortie structurée
Exemples d'utilisation
Automatisation du support client
Scénario : traiter les demandes clients avec accès à la base de données
- L'utilisateur soumet un ticket de support via le bloc API
- L'agent traite la demande avec les outils de la base de données produits
- L'agent génère une réponse et crée un ticket de suivi
- Le bloc Response envoie la réponse au client
Analyse de contenu multi-modèles
Scénario : analyser du contenu avec différents modèles IA
- Le bloc Function traite le document téléversé
- L'agent avec GPT-4o effectue l'analyse technique
- L'agent avec Claude analyse le sentiment et le ton
- Le bloc Function combine les résultats pour le rapport final
Assistant de recherche avec outils
Scénario : assistant de recherche avec accès au web et aux documents
- La requête utilisateur est reçue via l'entrée
- L'agent effectue des recherches web avec
scrydon:web(fetch-webpage) ougoogle:search(Custom Search) - L'agent récupère des documents internes via
scrydon:knowledge(RAG search) - L'agent compile un rapport de recherche complet
Bonnes pratiques
- Soyez précis dans les invites système : définissez clairement le rôle, le ton et les limites de l'agent. Plus vos instructions sont spécifiques, mieux l'agent pourra remplir sa fonction.
- Choisissez le bon réglage de température : utilisez des températures basses (0-0,3) lorsque la précision est importante, ou augmentez la température (0,7-2,0) pour des réponses plus créatives ou variées.
- Tirez parti des outils efficacement : intégrez des outils qui complètent la fonction de l'agent et renforcent ses capacités. Soyez sélectif dans les outils que vous fournissez pour ne pas surcharger l'agent. Pour des tâches avec peu de recoupements, utilisez un autre bloc Agent pour de meilleurs résultats.